Cette formation elasticsearch est le socle de toutes les autres : elle présente en profondeur le moteur de recherche et d'analytics basé sur Lucene, du point de vue de celui qui l'utilise — stocker des documents, les modéliser, les rechercher avec pertinence et en tirer des statistiques.
Le cours est à jour des versions Elasticsearch 8.x et 9.x : en plus des fondamentaux (mapping, analyse de texte, Query DSL, agrégations), il couvre ES|QL et la recherche vectorielle, sémantique et hybride. Chaque thème s'appuie sur un jeu de données concret et un lab, pour que vos équipes intègrent Elasticsearch dans leurs projets de manière autonome.
Objectifs pédagogiques
- Comprendre le fonctionnement d'Elasticsearch et de Lucene : index inversé, shards, near real-time.
- Indexer, mettre à jour et manipuler des documents, unitairement ou en masse.
- Modéliser ses données : mapping, types de champs, relations entre documents.
- Maîtriser l'analyse de texte pour une recherche pertinente, y compris en français.
- Écrire des requêtes avec le Query DSL et régler la pertinence des résultats.
- Produire des statistiques avec les agrégations et ES|QL.
- Mettre en œuvre une recherche vectorielle, sémantique et hybride.
- Construire les fonctionnalités d'un moteur de recherche applicatif : autocomplétion, suggestions, géo, highlighting.
Programme
Module 1 — Fondamentaux
- Historique, licences et cas d'usage : moteur de recherche, analytics, logs, base vectorielle.
- Lucene et l'index inversé ; Elasticsearch comme couche distribuée et API REST.
- Index, documents, shards et réplicas : ce qu'il faut savoir côté utilisateur ; near real-time et refresh.
- Démarrage rapide en local (Docker), Kibana Dev Tools, clients officiels (Python, Java, JavaScript…).
- Lab : premier index et premières requêtes.
Module 2 — Indexer et manipuler les documents
- Index, get, update (partiel, upsert, script), delete.
- Versioning et concurrence optimiste
(
if_seq_no/if_primary_term). - Bulk API : chargement en masse et gestion des erreurs.
- Update by query, delete by query, reindex.
- Lab : chargement d'un jeu de données réel.
Module 3 — Modélisation et mapping
- Types de champs : text, keyword, numériques, date, boolean, geo_point, flattened, dense_vector…
- Dynamic mapping, dynamic templates et mapping explicite ; multi-fields.
- Faire évoluer un mapping : ce qui est modifiable, ce qui impose un reindex.
- Relations : dénormalisation, nested, parent / child
(
join) — avantages et coûts. - Lab : conception du mapping d'un catalogue.
Module 4 — Analyse de texte
- Comment le texte est réellement stocké : analyzers, character filters, tokenizers, token filters ; Analyze API.
- Analyseurs de langue, français : élision, stemming, asciifolding, stop words.
- Synonymes (synonyms API), shingles, ngrams et edge ngrams, normalizers.
- Analyse à l'indexation vs à la recherche.
- Lab : analyseur personnalisé pour du contenu en français.
Module 5 — Rechercher avec le Query DSL
- Query context vs filter context.
- Requêtes full-text : match, match_phrase, multi_match, query_string, simple_query_string.
- Requêtes term-level : term, terms, range, exists, prefix, wildcard, fuzzy.
- Combiner avec
bool: must, should, filter, must_not. - Tri, pagination (from / size, search_after + point in time),
filtrage du
_source, collapse. - Lab : moteur de recherche multi-critères.
Module 6 — Pertinence et scoring
- Le scoring dans Lucene : de TF-IDF à BM25 ; Explain API.
- Boosts,
function_score,script_score, rank_feature, decay functions. - Rescoring et reranking.
- Mesurer la pertinence : Ranking Evaluation API.
- Lab : améliorer le classement des résultats.
Module 7 — Agrégations
- Metrics : avg, sum, min, max, stats, cardinality, percentiles (statistiques approximées).
- Buckets : terms, range, histogram, date_histogram, filters.
- Imbrication, pipeline aggregations, agrégations sur nested.
- Facettes de recherche, composite aggregation pour paginer.
- Lab : tableau de bord analytique en API.
Module 8 — ES|QL
- Le langage piped d'Elasticsearch : FROM, WHERE, EVAL, STATS, SORT, KEEP.
- Enrichissement et jointures : ENRICH, LOOKUP JOIN.
- ES|QL vs Query DSL : quand utiliser l'un ou l'autre.
- Lab : analyses ad hoc en ES|QL.
Module 9 — Recherche vectorielle, sémantique et hybride
- Embeddings et similarité ; champ
dense_vector, recherche kNN (HNSW), quantization. - Recherche sémantique :
semantic_text, ELSER (sparse), Inference API et modèles externes. - Recherche hybride : lexical + vectoriel, retrievers, Reciprocal Rank Fusion (RRF).
- Elasticsearch comme brique de RAG pour les applications d'IA générative.
- Lab : recherche hybride sur un corpus documentaire.
Module 10 — Fonctionnalités d'un moteur de recherche applicatif
- Autocomplétion : completion suggester, search_as_you_type.
- « Vouliez-vous dire » : term et phrase suggesters, fuzziness.
- Highlighting des résultats.
- Données géolocalisées : geo_distance, geo_bounding_box, tri par distance.
- Search templates, percolator, reindex sans interruption via les alias.
- Lab : barre de recherche complète.
Pour aller plus loin : l'exploitation d'un cluster en production est traitée dans la formation elasticsearch administration, la collecte de données dans la formation ELK / Elastic Stack et la visualisation dans la formation Kibana.
LE Formateur
Mathieu ELIE assure votre cours. Avec plus de 160 formations données sur les technos elastic, votre formateur passe aussi 50% de son temps en production en tant que consultant elk et elastic stack . Vous avez donc un formateur qui a aussi l'experience de la production.
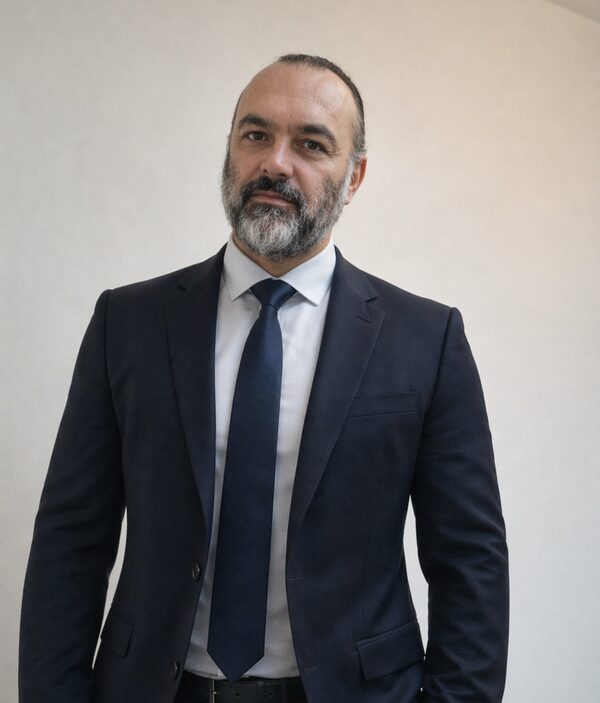
Mathieu ELIE
Expert Elasticsearch & Elastic Stack
C'est lui qui anime votre formation, du premier au dernier jour.
 Elastic Certified Engineer
- 160+ formations données
- Elasticsearch depuis 2011, 100 % Elastic depuis 2016
- 50 % du temps en production chez des clients (consulting)
- Conférencier, en français et en anglais
2 à 4 jours
Il est possible de moduler la durée en fonction de vos contraintes ou souhaits. Concrètement cela correspond à la modulation des temps de travaux pratiques et du niveau de détail des points développés.
sur devis
Les tarifs sont étudiés pour chaque demande, en inter ou intra-entreprise.
Formation remboursable OPCA / OPCO sur acceptation de votre dossier.
Sur mesure / personnalisation
Contactez moi pour personnaliser votre formation. J’adapte le programme, le lieu et la durée. Une partie consulting est également possible, par exemple sur la modélisation ou la pertinence de votre propre moteur de recherche.
Public
Développeurs, data engineers, architectes, chefs de projet techniques et toute personne amenée à intégrer ou utiliser Elasticsearch.
Pré-requis
Notions d'API REST et de JSON. Aucune connaissance préalable d'Elasticsearch n'est nécessaire.
Pédagogie
50 % théorie, 50 % pratique. Chaque module se termine par un lab sur un jeu de données concret, avec corrigé.
Supports
A la fin de la formation vous recevrez tous les supports de toutes mes formations au format numériques ainsi que tous les tps et leurs corrigés